搜索到
22
篇与
的结果
-
 从 0 到 1 架构 Web + Mobile 端到端自动化测试平台:Playwright + Appium + TypeScript 从 0 到 1 架构 Web + Mobile 端到端自动化测试平台:Playwright + Appium + TypeScript 当一个业务同时存在 Web、Android 和 iOS 三个客户端时,自动化测试最容易走向两个极端: 一种是三套测试工程各自发展,最终基础设施重复、测试数据重复、CI 重复; 另一种是为了“统一”而设计一个万能自动化框架,试图用同一套 Driver、Element API 同时操作浏览器和移动端,最后抽象层反而比业务代码更复杂。 本文介绍一种更适合中大型项目的架构: 执行引擎分开,业务能力共享,测试基础设施统一。 一、我们到底要解决什么问题? 假设一个产品同时拥有: Web 管理后台 Web 用户端 Android App iOS App 测试团队希望自动完成下面这些业务流程: 登录 ↓ 搜索商品 ↓ 加入购物车 ↓ 创建订单 ↓ 支付 ↓ 验证订单 这时候最直接的想法通常是: Web 自动化 Android 自动化 iOS 自动化 然后分别建立三套工程。 短期没有问题。 但当测试 Case 从几十条增长到几百甚至几千条后,就会逐渐出现这些问题: 自动化测试规模扩大 │ ┌────────────┼────────────┐ │ │ │ Web Android iOS │ │ │ 一套账号管理 一套账号管理 一套账号管理 一套测试数据 一套测试数据 一套测试数据 一套 API 一套 API 一套 API 一套日志 一套日志 一套日志 一套报告 一套报告 一套报告 问题本质不是: Playwright 和 Appium 怎么一起用? 真正的问题其实是: 如何让不同终端的自动化测试共享业务能力和基础设施,但又保持各自最合适的执行模型? 二、技术选型 这套架构采用: 语言 └── TypeScript Web └── Playwright Mobile ├── WebdriverIO ├── Appium ├── Android → UiAutomator2 └── iOS → XCUITest 工程管理 └── pnpm workspace CI ├── Jenkins ├── GitLab CI └── GitHub Actions 报告 ├── Allure ├── JUnit └── 自建测试报告平台 整体关系如下: flowchart LR A[TypeScript E2E Platform] A --> B[Web Tests] A --> C[Mobile Tests] B --> D[Playwright] D --> E[Chrome] D --> F[Firefox] D --> G[WebKit] C --> H[WebdriverIO] H --> I[Appium] I --> J[UiAutomator2] I --> K[XCUITest] J --> L[Android] K --> M[iOS] 为什么统一使用 TypeScript? 并不是因为 TypeScript 一定比其他语言更适合测试。 真正的价值是: Web 和 Mobile 可以共享类型、配置、API Client、测试数据、账号池和业务模型。 三、不要构建“万能 Driver” 架构设计中最重要的一个原则是: 不要把 Playwright 和 Appium 强行抽象成同一个底层 Driver。 很多自动化框架一开始都会尝试做类似这样的东西: class Element { async click() { if (platform === 'web') { // Playwright click } if (platform === 'android') { // Appium click } if (platform === 'ios') { // XCUITest click } } } 刚开始看起来非常优雅: element.click(); element.input(); element.wait(); 似乎 Web、Android、iOS 都统一了。 但随着业务复杂度提高,很快就会变成: if Web if Android if iOS if WebView if Native if Chrome if Safari if Element Scrollable if System Permission if Keyboard Visible if Android Version if iOS Version ... 最终得到的不是一个“统一自动化框架”。 而是: 一个比 Playwright 和 Appium 本身还复杂的中间层。 四、正确的抽象边界在哪里? 真正值得共享的是: 业务场景 测试数据 账号体系 API Client 环境配置 日志 报告 测试标签 CI 调度 而不应该强行共享: Locator Element Page Driver Gesture Browser Context Mobile Session 整体架构应该是: flowchart TD A[Business Scenario] A --> B[Web Flow] A --> C[Mobile Flow] B --> D[Page Object] C --> E[Screen Object] D --> F[Playwright] E --> G[WebdriverIO / Appium] F --> H[Browser] G --> I[Android / iOS] 一句话概括: 业务层统一,执行层隔离。 五、整体工程架构 推荐将整个自动化测试平台组织成 Monorepo。 e2e-automation/ │ ├── package.json ├── pnpm-workspace.yaml ├── tsconfig.base.json │ ├── packages/ │ │ ├── core/ │ │ │ │ └── src/ │ │ ├── config/ │ │ ├── api/ │ │ ├── data/ │ │ ├── accounts/ │ │ ├── logger/ │ │ ├── retry/ │ │ ├── assertions/ │ │ └── types/ │ │ │ ├── scenarios/ │ │ │ │ └── src/ │ │ ├── login/ │ │ ├── register/ │ │ ├── search/ │ │ ├── checkout/ │ │ └── profile/ │ │ │ ├── web-tests/ │ │ │ │ ├── playwright.config.ts │ │ │ │ │ ├── src/ │ │ │ ├── pages/ │ │ │ ├── components/ │ │ │ ├── fixtures/ │ │ │ └── helpers/ │ │ │ │ │ └── tests/ │ │ │ └── mobile-tests/ │ │ │ ├── wdio.shared.conf.ts │ ├── wdio.android.conf.ts │ ├── wdio.ios.conf.ts │ │ │ ├── src/ │ │ ├── screens/ │ │ ├── components/ │ │ ├── gestures/ │ │ ├── devices/ │ │ └── helpers/ │ │ │ └── tests/ │ ├── config/ │ ├── env/ │ ├── devices/ │ └── test-suites/ │ ├── scripts/ │ ├── run-web.ts │ ├── run-mobile.ts │ ├── prepare-test-data.ts │ └── cleanup-test-data.ts │ ├── artifacts/ │ ├── screenshots/ │ ├── videos/ │ ├── traces/ │ └── logs/ │ └── reports/ 这里最关键的是: core scenarios 这两个包不会关心: Browser 是 Chrome 还是 Safari 手机是 Android 还是 iPhone 底层是 Playwright 还是 Appium 它们主要负责: 环境 账号 测试数据 API 业务模型 日志 报告 六、Web:Page Object Web 使用 Playwright。 例如登录页: import { Page } from '@playwright/test'; export class LoginPage { constructor(private readonly page: Page) {} username = this.page.getByTestId('username'); password = this.page.getByTestId('password'); submit = this.page.getByTestId('login-button'); async login(username: string, password: string) { await this.username.fill(username); await this.password.fill(password); await this.submit.click(); } } 页面对象主要负责: Locator UI Operation Page Behavior 而不要承担业务流程。 例如下面这种代码就不建议放入 LoginPage: async loginAndCreateOrder() { // ... } 因为: Page Object 表示页面能力,不应该表示完整业务流程。 七、Mobile:Screen Object Mobile 使用: WebdriverIO ↓ Appium ↓ Android / iOS 登录页面可以写成: export class LoginScreen { get username() { return $('~username'); } get password() { return $('~password'); } get submit() { return $('~login-button'); } async login(username: string, password: string) { await this.username.setValue(username); await this.password.setValue(password); await this.submit.click(); } } Android 和 iOS 如果 UI 结构高度一致,可以共享部分 Screen。 但如果两端差异比较大,建议直接拆开: screens/ ├── android/ │ ├── LoginScreen.ts │ └── CheckoutScreen.ts │ └── ios/ ├── LoginScreen.ts └── CheckoutScreen.ts 不要为了“代码复用率”牺牲可维护性。 八、真正需要共享的是 Business Flow 假设我们有一个登录流程: export interface LoginFlow { login(user: TestUser): Promise<void>; } Web 实现: export class WebLoginFlow implements LoginFlow { constructor( private readonly loginPage: LoginPage ) {} async login(user: TestUser) { await this.loginPage.login( user.username, user.password ); } } Mobile 实现: export class MobileLoginFlow implements LoginFlow { constructor( private readonly loginScreen: LoginScreen ) {} async login(user: TestUser) { await this.loginScreen.login( user.username, user.password ); } } 于是业务测试可以变成: await loginFlow.login(user); await searchFlow.search('MacBook'); await cartFlow.addProduct(); const order = await checkoutFlow.checkout(); expect(order.success).toBe(true); 测试代码关注的是: 用户做了什么 而不是: 元素怎么点 元素怎么查 页面怎么滚 九、一条测试到底是怎么运行的? 整个执行链路如下。 flowchart TD A[开始测试] A --> B[加载运行环境] B --> C[创建测试账号] C --> D[准备测试数据] D --> E{测试平台} E -->|Web| F[启动 Playwright] E -->|Android| G[启动 Appium Android Session] E -->|iOS| H[启动 Appium iOS Session] F --> I[执行业务场景] G --> I H --> I I --> J[UI Assertion] J --> K[API / DB 验证] K --> L{是否成功} L -->|成功| M[记录测试结果] L -->|失败| N[截图 / 视频 / 日志 / Trace] N --> M M --> O[清理测试数据] O --> P[生成测试报告] 这里有一个非常重要的理念: 自动化测试不是单纯的 UI 操作。 完整测试实际上是: API + Test Data + UI + Assertion + Logging + Reporting 十、测试数据必须成为一等公民 很多 E2E 自动化项目最后不稳定,并不是 Playwright 不稳定。 也不是 Appium 不稳定。 而是: 测试数据不稳定。 例如: test('用户可以购买商品', async () => { await login('test001', '123456'); }); 这种代码隐藏了大量问题: 这个账号还存在吗? 余额够吗? 是否被其他测试占用? 是否已经购买过? 有没有被封? 环境数据是否一致? 更合理的方式是: const user = await testData.createUser({ balance: 10000, status: 'active' }); 然后: await loginFlow.login(user); 测试完成以后: await testData.cleanup(user); 测试生命周期应该变成: flowchart LR A[Test Case] A --> B[API 创建用户] B --> C[API 创建商品] C --> D[API 创建测试订单数据] D --> E[UI 执行核心业务] E --> F[API / DB 验证结果] F --> G[清理测试数据] 这样 UI 自动化只验证: 必须通过 UI 才能验证的内容。 十一、账号池设计 当 CI 开始并行运行以后,会出现另一个问题: Test 01 ─┐ Test 02 ─┼── test001 Test 03 ─┘ 三个 Case 同时使用一个账号。 后果通常是: 状态污染 订单冲突 购物车冲突 登录 Session 冲突 数据互相覆盖 因此建议设计: Account Pool 运行时: flowchart LR A[Test Worker 1] --> D[Account Pool] B[Test Worker 2] --> D C[Test Worker 3] --> D D --> E[test001] D --> F[test002] D --> G[test003] 基本接口可以是: const account = await accountPool.acquire({ type: 'normal-user' }); try { await runTest(account); } finally { await accountPool.release(account); } 这样才能真正支持稳定并发。 十二、Web 浏览器矩阵 Web 可以通过 Playwright Projects 定义浏览器矩阵: export default defineConfig({ projects: [ { name: 'chrome', use: { ...devices['Desktop Chrome'] } }, { name: 'firefox', use: { ...devices['Desktop Firefox'] } }, { name: 'webkit', use: { ...devices['Desktop Safari'] } } ] }); 执行关系: flowchart LR A[Web Test] A --> B[Chrome] A --> C[Firefox] A --> D[WebKit] B --> E[Result] C --> E D --> E 但并不意味着所有 PR 都要跑所有浏览器。 测试策略应该分层。 十三、Mobile 设备矩阵 Mobile 与 Web 最大的区别是: Web 并发资源通常是: CPU Memory Browser Worker 而 Mobile 真正受限制的是: Device Simulator Emulator 因此应该构建设备池: flowchart TD A[Mobile Test Queue] A --> B[Device Scheduler] B --> C[Android 01] B --> D[Android 02] B --> E[iPhone 01] B --> F[iPhone 02] C --> G[Test Case] D --> G E --> G F --> G 设备元数据建议维护: interface Device { id: string; platform: 'android' | 'ios'; version: string; model: string; status: 'idle' | 'busy' | 'offline'; } 以后可以进一步扩展成 Device Farm。 十四、测试标签体系 当 Case 达到几百条以后,不能再依靠目录决定执行策略。 建议采用 Tag。 例如: 运行级别 @smoke @regression 优先级 @p0 @p1 @p2 业务 @login @checkout @payment @search 平台 @web @android @ios 环境 @staging @production-safe 例如: test( '@p0 @smoke @checkout 用户可以完成购买', async () => { // ... } ); 然后执行: pnpm test --tag @smoke 或者: pnpm test --tag "@p0 && @checkout" 进一步还可以实现: pnpm test:web --tag @regression 以及: pnpm test:android --tag @smoke 十五、CI 怎么设计? 不要每次 Pull Request 都执行全部 E2E。 假设: Web Case 300 Android Case 200 iOS Case 200 如果全部执行: 700 Cases × 多浏览器 × 多设备 整个 Pipeline 会非常昂贵。 建议采用三级测试策略。 flowchart TD A[Pull Request] A --> B[P0 Smoke] B -->|Pass| C[Merge] B -->|Fail| D[Block Merge] C --> E[Core Regression] E --> F[Nightly] F --> G[Full Matrix] G --> H[Chrome] G --> I[Firefox] G --> J[WebKit] G --> K[Android Devices] G --> L[iOS Devices] 推荐: Pull Request P0 Smoke 核心链路 例如: 登录 搜索 下单 支付 目标: 5 ~ 15 分钟 Merge 执行: Core Regression 例如: 核心业务 核心页面 主要设备 Nightly 每天晚上执行: Full Regression 包括: Chrome Firefox Safari Android 多版本 iOS 多版本 十六、报告体系 报告不能只有: Passed Failed 一个成熟的 E2E 平台应该记录: Test Name Platform Environment Browser Device App Version Git Commit Start Time Duration Screenshot Video Trace Console Log Appium Log Network Log Error Stack 最终报告可以呈现: Run #10231 ────────────────────────────────── Web Chrome 145 / 147 Firefox 142 / 147 WebKit 144 / 147 Android Pixel 81 / 83 Samsung 79 / 83 iOS iPhone 15 82 / 83 ────────────────────────────────── Passed 573 Failed 11 Skipped 6 整体流程: flowchart LR A[Playwright Result] --> D[Report Aggregator] B[Android Result] --> D C[iOS Result] --> D D --> E[JUnit] D --> F[Allure] D --> G[Database] G --> H[Trend Dashboard] 十七、失败的时候到底保存什么? 一个失败 Case 至少应该留下: Screenshot Video Error Stack Console Log Device Log Web 还可以保存: Playwright Trace Network Browser Console DOM Snapshot Mobile 可以保存: Appium Server Log Device Log Screen Recording Page Source 理想状态是开发者看到: Checkout failed 之后,不需要 QA 手工复现。 而是可以直接看到: 哪一步失败 失败时页面长什么样 前端报了什么错 接口有没有失败 设备有没有异常 十八、Flaky Test 怎么处理? E2E 自动化最大的敌人不是 Fail。 而是: Flaky。 也就是: 第一次失败 第二次通过 第三次又失败 如果简单粗暴地设置: retry = 3 很多问题会被掩盖。 更合理的方法: flowchart TD A[Test Failed] A --> B[Retry] B --> C{Retry Result} C -->|Fail| D[Real Failure] C -->|Pass| E[Mark Flaky] E --> F[Flaky Database] F --> G[Trend Analysis] G --> H{超过阈值?} H -->|Yes| I[创建治理任务] H -->|No| J[继续观察] 建议给每一个 Case 维护: Owner Failure Rate Flaky Rate Average Duration Last Failure 甚至可以设置: Flaky > 5% 自动通知负责人。 十九、完整自动化测试平台 随着能力逐步增加,最终整个测试平台会演进成: flowchart TB A[Developer / QA] A --> B[Test CLI] B --> C[Test Orchestrator] C --> D[Web Runner] C --> E[Mobile Scheduler] D --> F[Playwright] E --> G[Android Device Pool] E --> H[iOS Device Pool] F --> I[Business Scenario] G --> I H --> I I --> J[Test Infrastructure] J --> K[Account Pool] J --> L[Test Data] J --> M[API Client] J --> N[Config] J --> O[Logger] I --> P[Test Artifacts] P --> Q[Screenshot] P --> R[Video] P --> S[Trace] P --> T[Logs] Q --> U[Report Platform] R --> U S --> U T --> U U --> V[Trend Analysis] U --> W[Flaky Analysis] U --> X[Alert] 这时候它已经不再只是一个: 自动化脚本仓库 而是一个真正的: E2E Automation Platform 二十、推荐实施路线 如果从 0 开始,不建议一上来就做: 设备云 测试管理后台 账号中心 报表中心 调度中心 Flaky AI 分析 第一阶段最重要的是: 跑通闭环。 Phase 1:基础能力 先实现: Playwright Appium TypeScript pnpm workspace 然后选三个 Case: Login Search Checkout 要求: Web ✓ Android ✓ iOS ✓ Phase 2:基础设施 增加: Test Data Factory Account Pool API Client Environment Config Logging Artifacts Phase 3:CI 实现: PR Smoke Merge Regression Nightly Full Regression Phase 4:设备池 逐渐支持: Android Emulator Android Real Device iOS Simulator iOS Real Device Phase 5:平台化 最后才进入: Report Platform Device Farm Flaky Dashboard Trend Analysis Quality Dashboard Alert Case Owner 整个演进路线: flowchart LR A[脚本] --> B[工程化] --> C[基础设施] --> D[CI] --> E[设备池] --> F[报告平台] --> G[质量平台] 二十一、三个最值得坚持的设计原则 最后总结一下这套架构中最重要的三个原则。 1. 执行引擎分开 Web ↓ Playwright Mobile ↓ Appium 不要为了统一而统一。 2. 业务能力共享 共享: Scenario Test Data API Account Config Logger Report 而不是: Element Driver Locator 3. UI 只负责验证 UI 能够通过 API 完成的: 创建用户 创建订单 创建商品 初始化数据 清理数据 尽量不要通过 UI 做。 UI 自动化应该把时间投入到: 用户真正看到和操作的关键路径 二十二、最终架构 最终推荐的结构可以总结为: E2E Automation Platform │ ┌───────────┴───────────┐ │ │ Playwright Appium │ │ Web WebdriverIO │ ┌──────┴──────┐ │ │ Android iOS UiAutomator2 XCUITest ────────────────────────────────────────────── Shared Infrastructure ────────────────────────────────────────────── TypeScript Business Scenario Test Data Factory Account Pool API Client Environment Config Logging Reporting Tagging Artifacts CI Orchestrator Device Scheduler 架构原则可以浓缩成一句话: 执行引擎分开,业务能力共享,基础设施统一。 当项目只有十几条自动化 Case 时,架构可能并不重要。 但当 Case 达到: 100 500 1000+ 真正决定这个项目能不能继续维护的,已经不是: 某一个 Locator 怎么写 而是: 测试数据如何管理? 设备如何调度? 测试如何并发? 失败如何定位? Flaky 如何治理? 多平台如何共享业务能力? CI 如何控制执行成本? 这也是自动化测试从: “写脚本” 走向: “工程化” 再走向: “平台化” 最关键的一步。
-
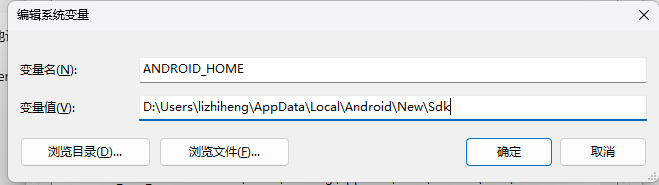
WebDriverIO与Appium本地开发环境部署(随手记) WebDriverIO与Appium本地开发环境部署 WebDriverIO V8 Appium 需要环境 浏览器:FireFox、Chrome Android环境:Android Studio、adb、Andorid SDK 配置Android环境变量 配置ANDROID_HOME ,Android SDK根据自己本地的地址来 配置环境变量 %ANDROID_HOME%\platform-tools %ANDROID_HOME%\emulator %ANDROID_HOME%\tools\bin 创建一个虚拟机在控制台验证 控制台输入adb devices 安装appium server 客户端 地址:https://github.com/appium/appium-desktop 安装完运行 默认Port:4723 配置Host:127.0.0.1 点击Edit Configurations 配置ANDROID_HOME 保存并重启 根据自己的Android SDK目录配置,如果这里没有配置,系统环境变量也是没有用的 安装appium cli node version: >20.18.1 npm i -g appium WebDriverIO 各个浏览器需要的驱动 chromeDriver各个版本的驱动下载地址 https://www.cnblogs.com/aiyablog/articles/17948703 最新版本的chromeDriver的下载地址 https://googlechromelabs.github.io/chrome-for-testing/ 在浏览器chrome测试,需要浏览器的版本跟chromeDriver对应 edge 的驱动无法下载,需要离线下载 小程序自动化测试 环境配置:开启微信开发者工具服务端口 点击=》设置=》安全设置
-
-
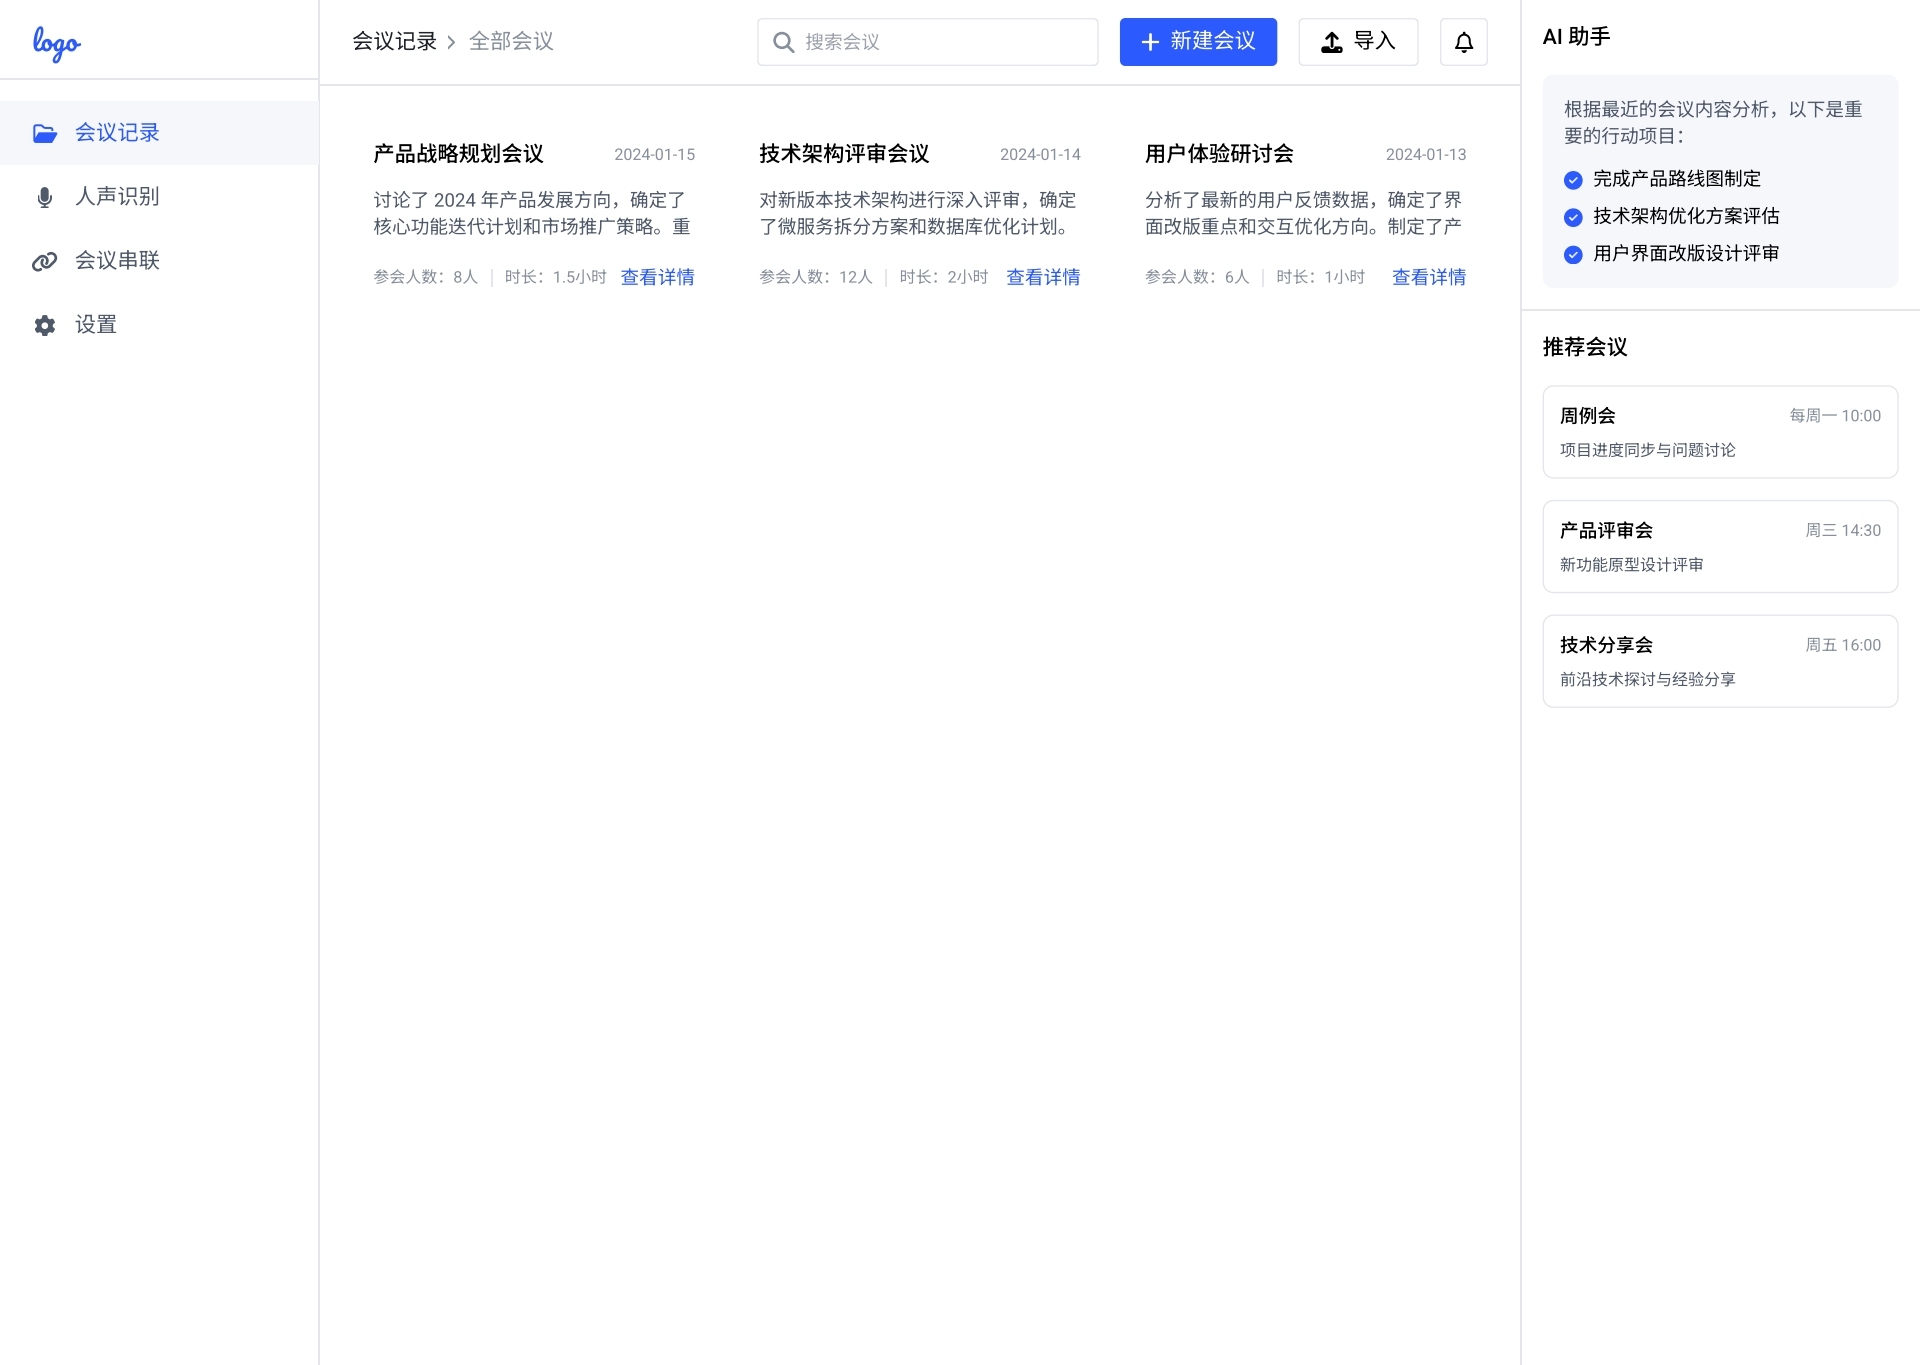
用AI生成的原型设计稿效果还可以 用AI生成的原型设计稿效果还可以 提示词如下 # 主界面布局 ## 整体结构 - **简洁的双栏式布局**:左侧窄导航栏、右侧宽内容区 - **顶部标题栏**:包含应用图标和最小化/最大化/关闭按钮 - **底部帮助按钮**:提供快速访问支持资源 ## 左侧导航栏 - **垂直排列的四个主要功能图标**:会议、人声、串联、设置(底部为帮助按钮) - **每个图标配有简洁文字标签** - **采用简约图标设计**,突出功能识别度 - **当前选中的功能以高亮状态显示** --- ## 功能区块设计 ### 1. 会议记录区域 #### 文件导航子菜单 - 位于左侧导航栏右侧,展示分类文件夹 - 包含四个主要选项: - **最近文件** - **我的文件** - **收藏文件** - **垃圾箱** - 每个选项配有直观图标,点击后在主内容区显示对应内容 #### 主内容区文件列表 - **顶部功能区**: - **开始录音按钮** - **上传音频按钮** - **搜索框** - **表格式文件列表**,包含列标题: - 名称 - 类型 - 时长 - 创建时间 - 操作 - **空白状态** 显示提示信息和操作建议 - **列表支持排序和筛选功能** --- ### 2. 录音/会议详情视图 - 点击 **"开始录音"** 后转换为录音界面,显示 **波形图和实时转写内容** - **会议详情页面** 分为上下两部分: - **音频控制** - **文本转写** - **按发言人分色显示转写文本** - **右侧工具栏** 提供: - **编辑** - **导出** - **分享功能** --- ## 视觉规范 ### 色彩系统 - **主色**:`#2B5BFF`(品牌蓝) - **辅助色**:`#F5F7FA`(背景灰) - **文字色**: - 主要文字:`#1D2129` - 次要文字:`#4E5969` - 说明文字:`#86909C` - **边框色**:`#E5E6EB` - **分割线**:`#E5E6EB` - **背景色**: - **主背景**:`#FFFFFF` - **次要背景**:`#F5F7FA` ### 字体规范 #### 标题 - **H1**:20px, Medium - **H2**:18px, Medium - **H3**:16px, Medium #### 正文 - **主要文字**:14px, Regular - **次要文字**:13px, Regular - **辅助文字**:12px, Regular --- ### 间距规范 - **内容区块间距**:24px - **组件内部间距**:16px - **文本行高**:1.5 - **图标尺寸**:16px / 20px / 24px ### 阴影效果 - **浅阴影**:`0 2px 4px rgba(0,0,0, 0.05)` - **中阴影**:`0 4px 8px rgba(0,0,0, 0.1)` - **深阴影**:`0 8px 16px rgba(0,0,0, 0.15)` ### 圆角规范 - **大圆角**:8px - **中圆角**:4px - **小圆角**:2px APP的效果也还可以
-
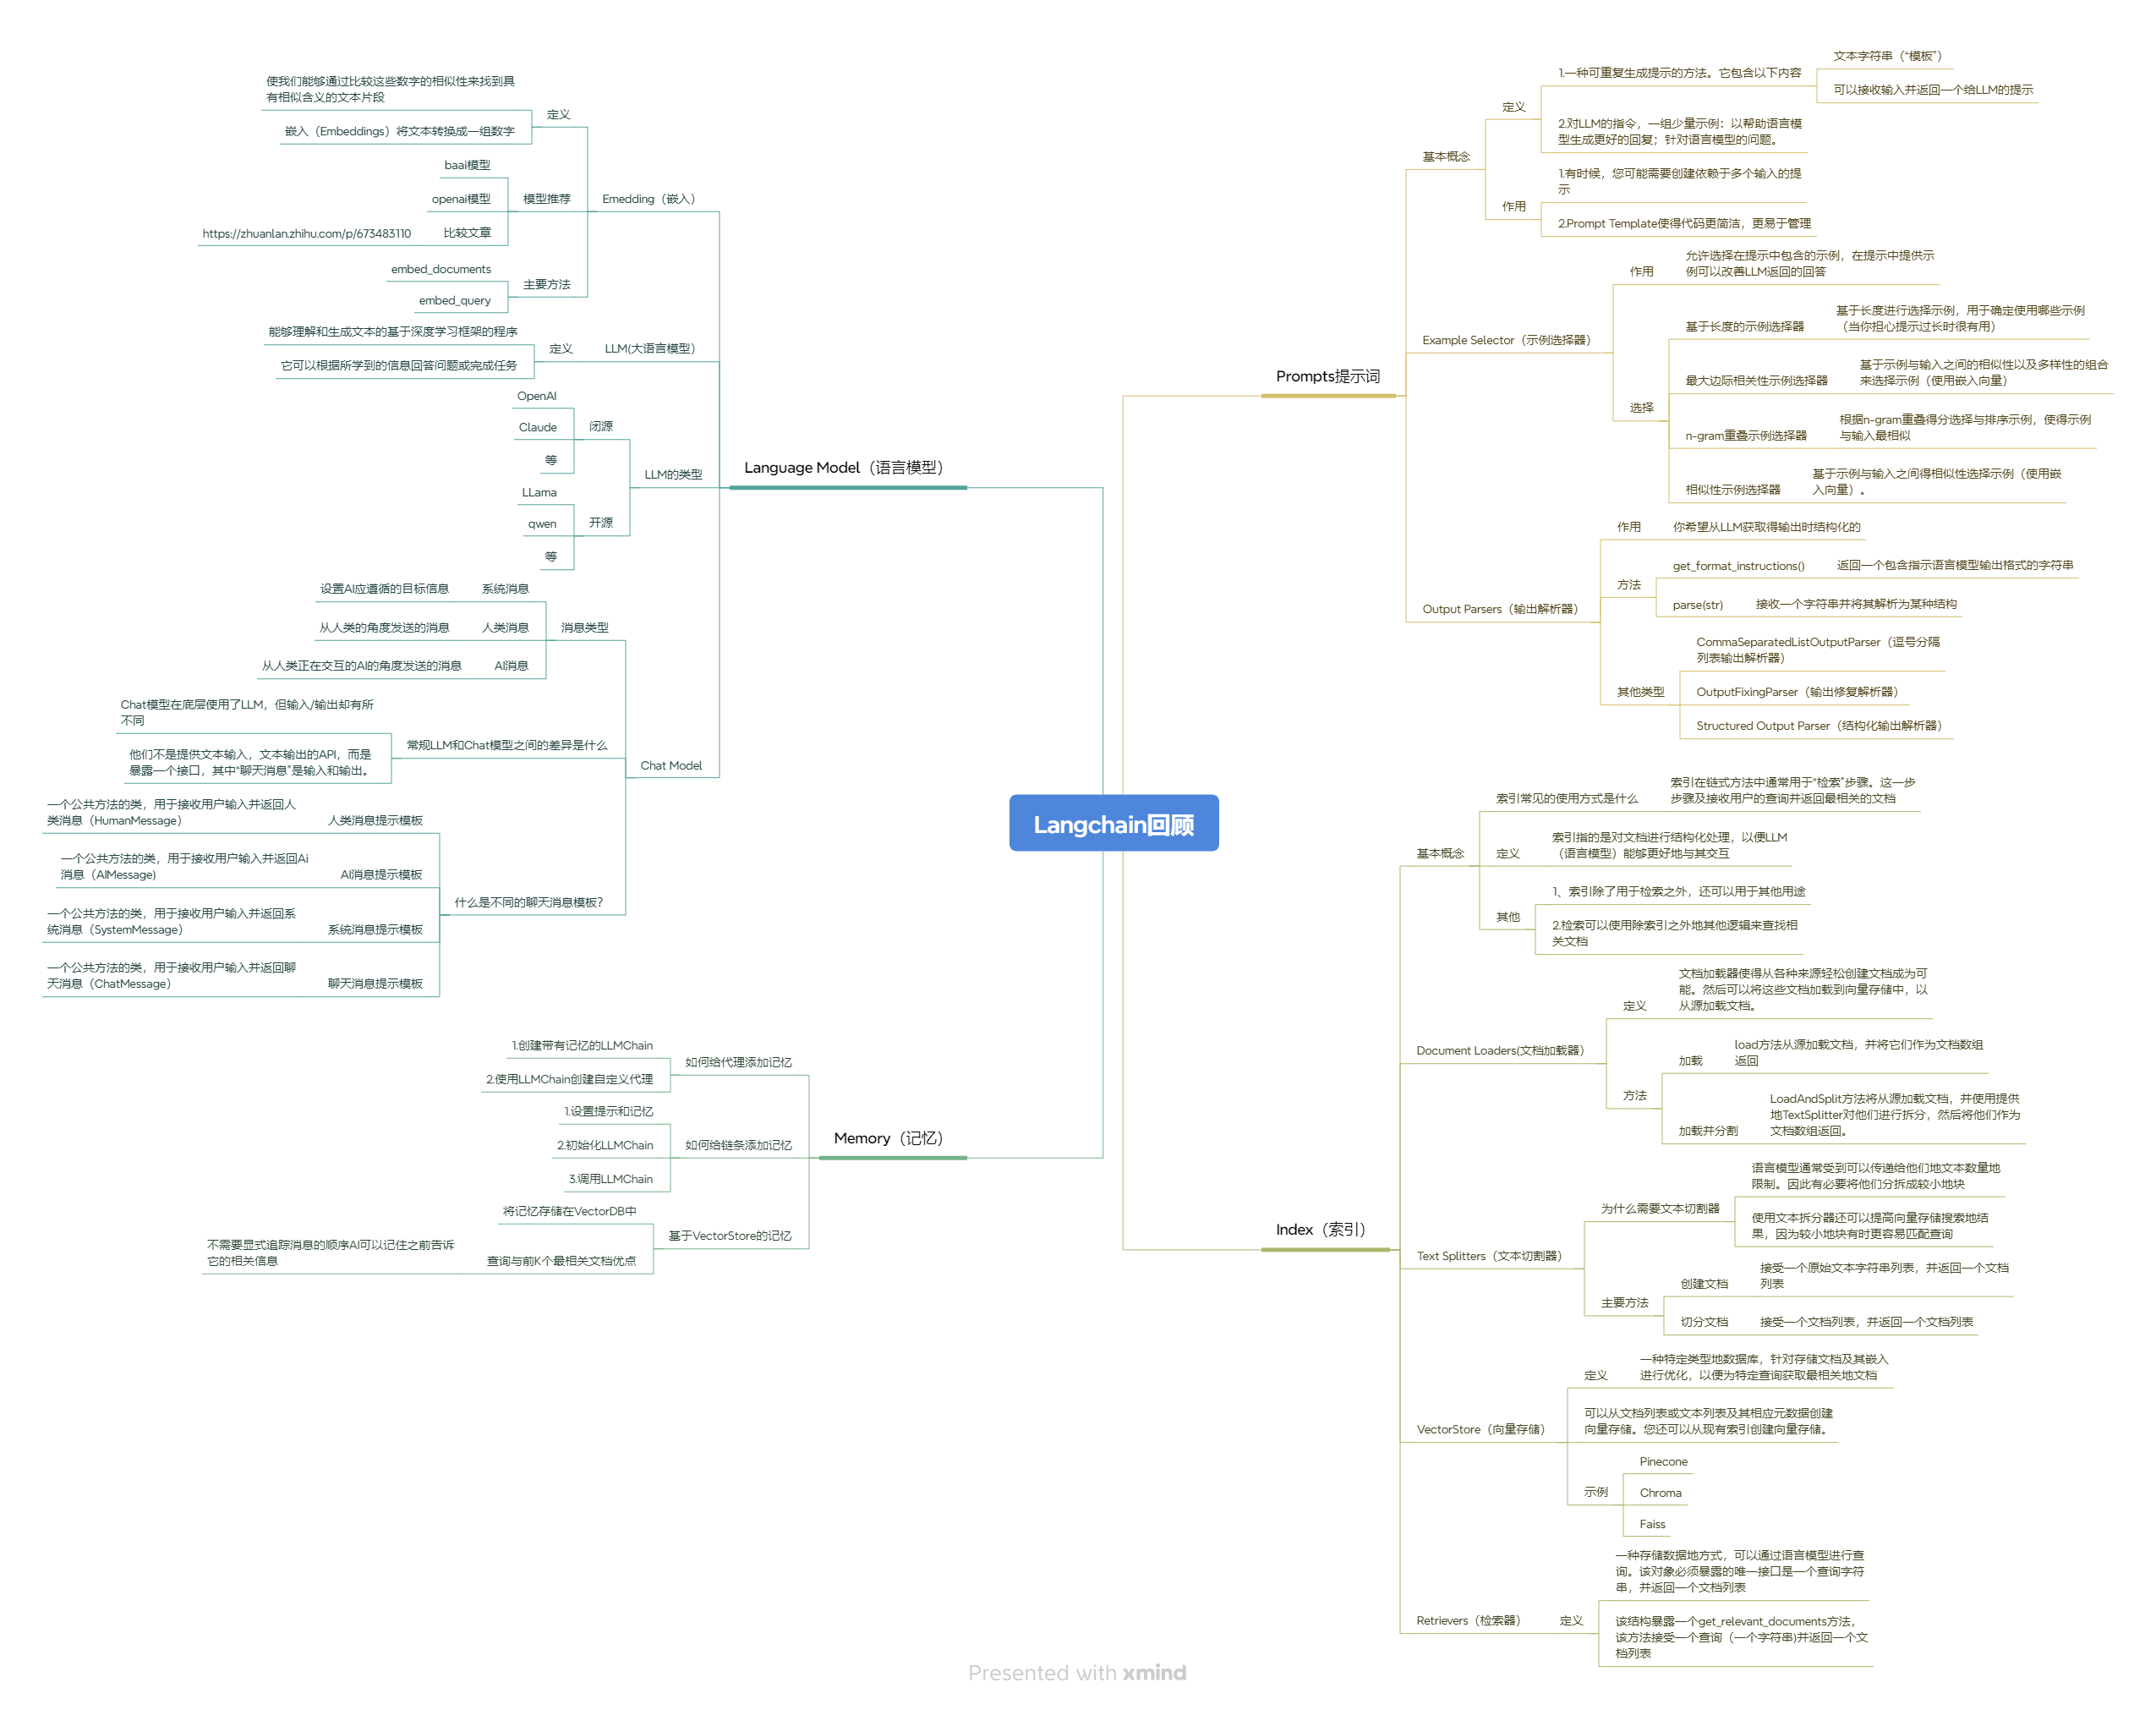
Langchain 回顾 🚀打造 AI 应用的核心利器 Langchain 是一个专为构建基于大语言模型(LLM)的应用而生的强大工具。它将 LLM、向量数据库、记忆机制、提示模板等模块进行了系统整合,大大简化了复杂 AI 应用的开发流程。本文将结合思维导图,对 Langchain 的核心能力做一个全面回顾,并介绍其生态工具 —— LangSmith,让我们能够对 LLM 应用进行高效调试与评估。 🧠 一、Language Model(语言模型) Langchain 提供了对多种主流 LLM 的集成,包括: OpenAI、ChatGLM、Claude、LLaMA、Qwen 等主流模型 支持封装为 LLM、Chat Model 两种类型 提供如 HumanMessage、SystemMessage、AIMessage 等统一结构,构建清晰上下文 支持 Embedding,集成了 text2vec、openai-embeddings 等方案 🧾 二、Prompt 模块(提示词构建) Langchain 封装了 Prompt 构建、示例选择、输出解析等功能: PromptTemplate:参数化构建提示词模板 ExampleSelector:支持基于语义相似度选择 few-shot 示例 Output Parsers:将 LLM 输出转为结构化数据,如 JSON、列表等 🧠 三、Memory(记忆模块) 用于保存对话历史、构建上下文感知的智能体(Agent)系统: 支持 ConversationBufferMemory、SummaryMemory、VectorStoreMemory 等 能力包括短期记忆(会话)与长期记忆(知识) 📚 四、Index 模块(索引与检索) Langchain 提供完整的 RAG 流程: 文档加载(Document Loaders):支持 txt、PDF、Notion、Web 等 文本切分(Text Splitters):如 RecursiveCharacterTextSplitter 向量数据库(Vector Store):支持 FAISS、Chroma、Weaviate 等 检索器(Retriever):封装 .as_retriever() 进行文档查询 🧪 五、LangSmith:Langchain 应用的调试和评估平台 LangSmith 是 Langchain 官方出品的可视化调试与监控平台,专门用于: 🔍 1. 调试链式调用过程 记录每一步链的调用细节 可视化展示 Prompt 输入、输出及 Token 使用情况 支持逐步调试复杂链(Chain)和 Agent 执行流程 📊 2. 性能评估与对比 定义多个 Prompt 模板进行 A/B 测试 自动记录响应时间、成功率、评分等指标 与 OpenAI Function、Tool 使用情况无缝集成 ☁️ 3. 生产环境监控 监控 Agent 的运行行为、失败重试 接入自定义评分函数,对每次调用进行标注 ✨ 总结一句话: LangChain 让你快速构建 LLM 应用,LangSmith 让你安心上线并优化它。 🧩 六、应用场景示例 聊天机器人 / 客服系统 企业文档问答 / 私人知识库 表单解析 / 结构化信息提取 智能搜索系统(结合向量检索) Prompt 模板测试平台(结合 LangSmith) 一个比较完整的python demo实现 #langsmith 的key #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 import os os.environ['USER_AGENT'] = 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.3' from langchain_community.llms import Ollama from langchain import hub from langchain.agents import create_openai_functions_agent from langchain.agents import AgentExecutor from langchain_core.messages import HumanMessage, AIMessage from langchain_community.vectorstores import FAISS from langchain_community.document_loaders import WebBaseLoader from langchain_text_splitters import RecursiveCharacterTextSplitter from langchain.tools.retriever import create_retriever_tool from langchain_community.tools.tavily_search import TavilySearchResults from langchain_ollama import OllamaEmbeddings from langchain_ollama import OllamaLLM # from langchain.pydantic_v1 import BaseModel, Field from pydantic import BaseModel, Field from fastapi import FastAPI from typing import List from langserve import add_routes from langchain_core.messages import BaseMessage ### 1.加载检索器 loader = WebBaseLoader("https://docs.smith.langchain.com/user_guide") docs = loader.load() text_splitter = RecursiveCharacterTextSplitter() documents = text_splitter.split_documents(docs) embeddings = OllamaEmbeddings(base_url="http://172.16.1.27:11434", model="nomic-embed-text:latest") vector = FAISS.from_documents(docs,embeddings) retriever = vector.as_retriever() ### 2. 创建工具 retriever_tool = create_retriever_tool( retriever, "langsmith_search", "搜索与LangSmith相关的信息。有关LangSmith的任何问题,您必须使用此工具!", ) search = TavilySearchResults() tools = [retriever_tool, search] ### 3.创建代理人 # 加载模型 llama = OllamaLLM(model="llama3.2-vision:latest",base_url="http://172.16.1.27:11434") # 获取要使用的提示 - 您可以修改此提示! prompt = hub.pull("hwchase17/openai-functions-agent") agent = create_openai_functions_agent(llama, tools, prompt) agent_executor = AgentExecutor(agent=agent, tools=tools, verbose=True) # 4. 应用程序定义 app = FastAPI( title="LangChain服务器", version="1.0", description="使用LangChain的可运行接口的简单API服务器", ) # 5. 添加链路由 class Input(BaseModel): input: str chat_history: List[BaseMessage] = Field( ..., extra={"widget": {"type": "chat","input":"location"}}, ) class Output(BaseModel): output: str add_routes(app, agent_executor.with_types(input_type=Input, output_type=Output), path="/agent") if __name__ == "__main__": import uvicorn uvicorn.run(app, host="localhost", port=8000) 🧷 七、总结 Langchain 是构建大模型应用的主干框架,围绕核心模块 —— Prompt、Memory、Index、LLM,打通了从数据到生成的全链路。而 LangSmith 则作为配套工具,填补了 调试、测试、监控 的空白,帮助我们更好地构建可信的 AI 应用。 好的!既然你希望对比 Langchain + LangSmith 与其它技术方案,那我们可以从几个维度来做一个 横向对比分析,让你的博客不仅回顾 Langchain,还凸显它的优势和适用场景。 🧭 Langchain 与其他 LLM 应用框架的对比分析 在构建 LLM 应用时,除了 Langchain,还有不少热门的框架和工具,比如: 框架名称 核心特点 是否组件化 是否支持 Agent 调试能力 主打场景 Langchain 模块化封装 Prompt、Memory、索引、Agent ✅ ✅ ✅(搭配 LangSmith) RAG、ChatBot、Agent LlamaIndex 强调数据索引能力,集成多种文档加载/拆分方式 ✅ ⚠️(基础 Agent 支持) ❌ 文档问答、知识库 Haystack 企业级搜索和问答,支持自定义 Pipeline ✅ ✅ ✅(较重配置) 企业内部搜索、QA Autogen (MS) 多 Agent 协作框架,适合任务分工 ⚠️(较弱) ✅(核心) ❌(需配合日志) Agent 协作系统 Flowise 可视化 Langchain,拖拽式搭建 ✅(UI) ✅(底层用 Langchain) ✅(UI可视化) 快速原型、低代码 🔍 详细维度分析 1. 开发体验 对比项 Langchain LlamaIndex Haystack Autogen Flowise 上手难度 中(模块较多) 低(专注文档检索) 中高(配置多) 高(偏研究) 低(拖拽) 模块化 ✅ ✅ ✅ ⚠️ ✅ 类型支持 文档问答、对话、Agent 文档问答 QA Pipeline 多智能体任务 Chat/RAG 📌 如果你要构建复杂的 AI 应用,Langchain 的模块化设计 + LangSmith 调试工具,开发体验更全面。 2. 文档问答能力(RAG 架构支持) 对比项 Langchain LlamaIndex Haystack 向量索引支持 ✅(多种 VectorStore) ✅ ✅ 文档加载丰富度 ✅ ✅ ✅ 拆分策略 丰富(Recursive、Token等) 丰富 主要基于段落 多源融合 ✅ ✅ ✅ 检索方式灵活性 高(自定义 Retriever) 中 中 📌 Langchain 与 LlamaIndex 都支持强大的 RAG,Langchain 更适合自定义 Agent 与对话流整合。 3. Agent 能力对比 对比项 Langchain Agent Autogen Haystack 多工具调用 ✅ ✅ ✅(较少) 工具链整合 ✅(Tool/Toolkits) ✅(需自建 Tool) ⚠️ 多 Agent 协作 ✅(Router Chain) ✅(核心能力) ❌ 日志追踪 ✅(配合 LangSmith) ❌ ✅(基本) 📌 如果你是搞 Agent 系统的,Autogen 适合多智能体协作研究,但 Langchain 更适合落地和定制。 4. 调试与监控(LangSmith 优势突显) 框架 是否支持可视化调试 是否支持运行监控 自定义评分支持 是否 SaaS 服务 Langchain + LangSmith ✅ ✅ ✅ ✅(LangSmith 平台) LlamaIndex ❌ ❌ ❌ ❌ Haystack 部分 部分 需手动配置 ❌ Autogen ❌(手工打印) ❌ ❌ ❌ 📌 LangSmith 是目前 最适合 LLM 应用调试的可视化平台,对链条调用非常透明。 ✅ 总结:我该选谁? 你想快速构建实用型 AI 应用(问答、客服、Agent):用 Langchain + LangSmith 你只想搞定文档问答系统:可以考虑 LlamaIndex 你有企业级搜索需求:考虑 Haystack 你研究智能体协作:玩玩 Autogen 你是产品经理或低代码开发者:试试 Flowise